
esp32-iphone-agent
onehumanbeing
Let an AI model use a real iPhone with a $7 ESP32: AirPlay eyes, USB HID hands, any OpenAI-compatible vision model. No Mac, no developer account, no jailbreak.
我们跑过,装得上
GitHub 源码Swift昨天
2源码
zhu1090093659/dsh-web-ui#packages/dsh-tool-describe-image
给纯文本模型补视觉:describe_image 把本地路径/URL/附件图片交给可配置的 OpenAI 兼容视觉端点,进会话的只有返回文本。
安装
这个插件放在一个大仓库的子目录里,`dsh plugin add` 够不到它——它转发给 pnpm,而 pnpm 会把 `#` 后面的内容当成分支或 commit。请先 clone 仓库,再用 DSH 插件面板的 repository 源添加,或者请作者发一个 npm 包。
我们跑过之后
我们跑过,装得上
这里每条命令都在一次性容器里、对着干净 profile 真跑过,结果取自 harness 自己的记录,不是读源码猜的。 最近一次 1 个月前.
挂进你的 README
给维护者的:badge 取这条 listing 最近一次 sandbox 实测的结果,重跑之后它自己会变,读者点开就是这页的完整记录。
安装前须知
安全
我们这次实装里没有构建脚本被拦。
来源:我们在沙箱里的实装,1 个月前。
package.json 里没有 preinstall / install / postinstall 脚本。
来源:最近一次同步时读到的 GitHub 上的 package.json。prepare 没有记录——它只在从 GitHub 装时执行,被 pnpm 拦下时会出现在「构建脚本」那一行。
既没提 shell 命令,也没提密钥。
来源:对 README 做的关键词匹配,只提示它可能碰到什么,不是代码分析。
这不是安全审计。上面是一次实装记录加两次文本扫描,没有人替你读过这个插件的代码。插件带着你 agent 的权限在跑。
是什么 — dsh-tool-describe-image 是纯文本模型的图像描述工具。支持将本地路径、URL或附件发送至配置的 OpenAI 兼容视觉端点,仅返回文本进入会话。
谁该装 — 在使用 DeepSeek Harness 的纯文本模型处理图像附件时,用户适合安装此插件。 使用支持原生视觉模型的用户可以选择不安装,因为他们的模型有内置图像处理能力。
注意 — 在全新 profile 中安装并注册测试通过,未发现明显的坑。 静态检查未发现任何问题。
锐评 — 我会装,因为它让纯文本模型在会话中处理图像输入。
grok-4.6 写的,只当参考,不当结论。里面说装得上或装不上,是在干净 profile 里真跑过的;其余都是读仓库读出来的。以实际运行为准。
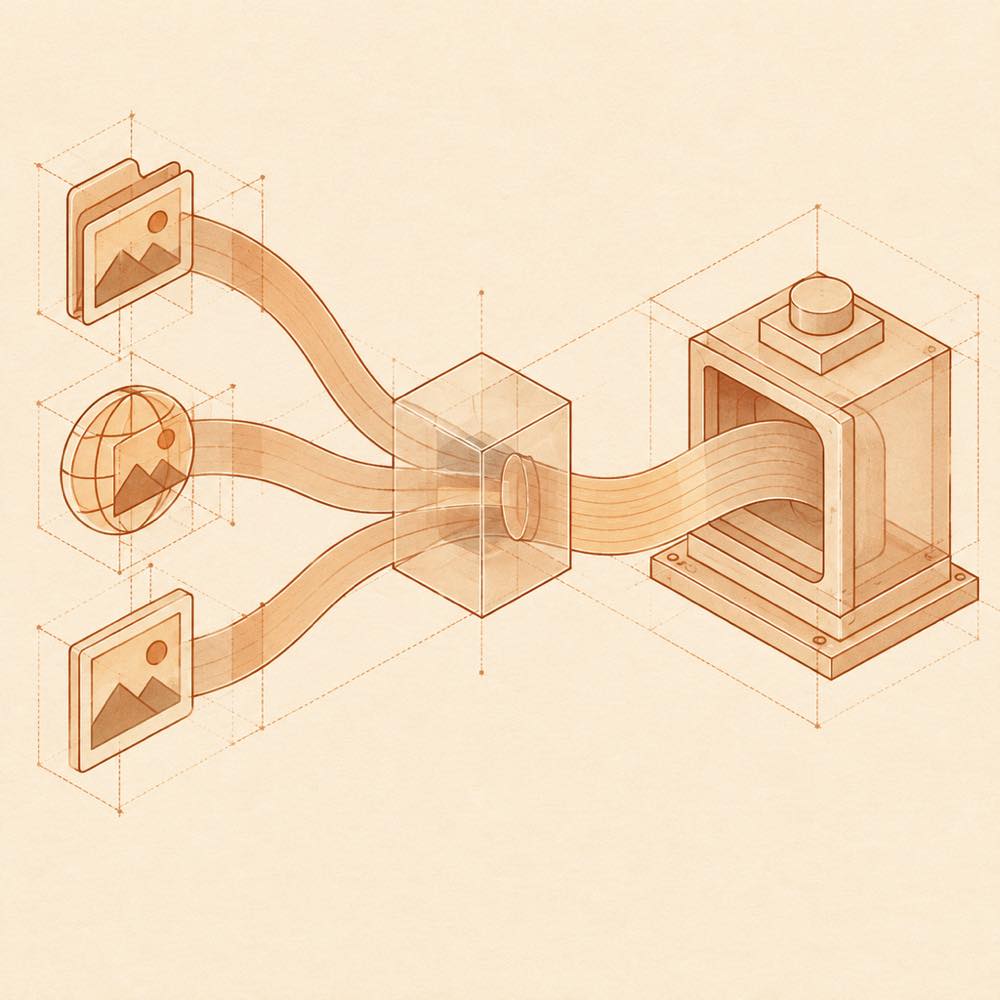
dsh-tool-describe-image 是一个为纯文本模型补充图片理解能力的 DeepSeek Harness 插件。它提供 describe_image 工具,接收本地路径、URL 或附件中的图片,将图片发送到可配置的 OpenAI 兼容视觉端点,再把端点返回的文字放入当前会话。进入 agent 会话的只有文字结果,不是原始图片,因此适合主模型不支持视觉输入、但任务仍需要读取图片内容的场景。
DeepSeek Harness 插件的工作边界很明确:图片由视觉端点处理,文本模型只消费返回的描述或回答。使用前需要准备可用的 OpenAI 兼容视觉 API,并完成端点配置。如果当前模型本身已经支持图片,安装这个插件会重复已有能力;如果图片不能发送到所配置的外部或独立视觉服务,也不应使用它。现有说明没有给出具体配置键、默认值、鉴权方式或安装命令,部署时需要再查看源码仓库中的配置实现。
插件使用可配置的 OpenAI 兼容视觉端点处理图片。现有文档没有列出具体配置键、默认值、环境变量或鉴权参数,因此不能据此写出固定配置示例。部署前应以源码仓库中的实际配置实现为准。
插件提供 describe_image 工具。输入可以是本地图片路径、图片 URL 或附件。DeepSeek Harness 将输入图片交给已配置的视觉端点,再把端点返回的文字写入当前会话。
处理流程分为三步:
describe_image 接收图片来源;因此,agent 使用的是视觉端点生成的描述或回答,而不是图片数据本身。
需要由 DeepSeek Harness 承载插件,并准备可用且已配置的 OpenAI 兼容视觉 API。现有说明未给出平台限制、版本要求、命令行参数或单行安装方式。若主模型已经支持图片输入,使用此工具属于重复配置;若端点不可用,工具也无法完成图片处理。
根据项目自己的文档整理,会跟着上游更新。两边对不上时以源码仓库为准—— 去 GitHub 看原始 README
同一分类
onehumanbeing
Let an AI model use a real iPhone with a $7 ESP32: AirPlay eyes, USB HID hands, any OpenAI-compatible vision model. No Mac, no developer account, no jailbreak.
我们跑过,装得上
Anionex
为纯文本模型"看图“设计更好的视觉工具箱和技能,支持多图理解,图片问答,前端UI还原、GUI 自动化等,并可选无缝接入多个主流agent,直接识别粘贴图片| A vision toolkit and skill designed for text-only llms — image Q&A, long-screenshot OCR, frontend UI restoration, and GUI automation, with optional seamless integration for Codex, Claude Code, Pi, Oh My Pi, and OpenCode
我们跑过,装得上
ysr666
为纯文本 Agent 提供视觉能力:内置免 Key 视觉链 + 像素级视觉工具(看图问答、定位、裁剪、像素对比、取色、OCR、矢量化、抠图、截图);粘贴图片即可用。
我们跑过,装得上
Anionex
让纯文本模型处理视觉任务:粘贴图片后自动切换到 Vision Toolkit 变体,支持图片问答、多图比较、长截图 OCR、截图还原前端 UI、元素定位与像素对比。默认无需 API Key——图片经作者自建的免费服务处理,每台机器每天 100 张;也可改为指向自己的服务商。
DeepSeek Harness 0.2.2-rc.1 拒装最新版
omdsh-dev
Chrome sidebar extension that lets DeepSeek Harness operate your browser directly, no vision capabilities required. 一款 Chrome 侧边栏扩展程序,可让 DeepSeek Harness 直接操控您的浏览器,无需视觉能力。
我们跑过,装得上